分析代码(Python,390 行)
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = 'SimHei'
plt.rcParams['axes.unicode_minus'] = False
data = pd.read_excel("附件 1. 某市监测点数据.xls")
print(data)
data = data.replace('--', np.nan)
data['可吸入颗粒物'] = data['可吸入颗粒物'].fillna(data['可吸入颗粒物
'].interpolate())
data.drop(['日期', '空气质量指数', '首要污染物', '空气质量指数级别', '空气质量
指数类别'], axis=1, inplace=True)
print(data)
data_corr = data.corr(method='pearson', min_periods=1)
data_corr.to_excel('./pearson.xls')
data_corr
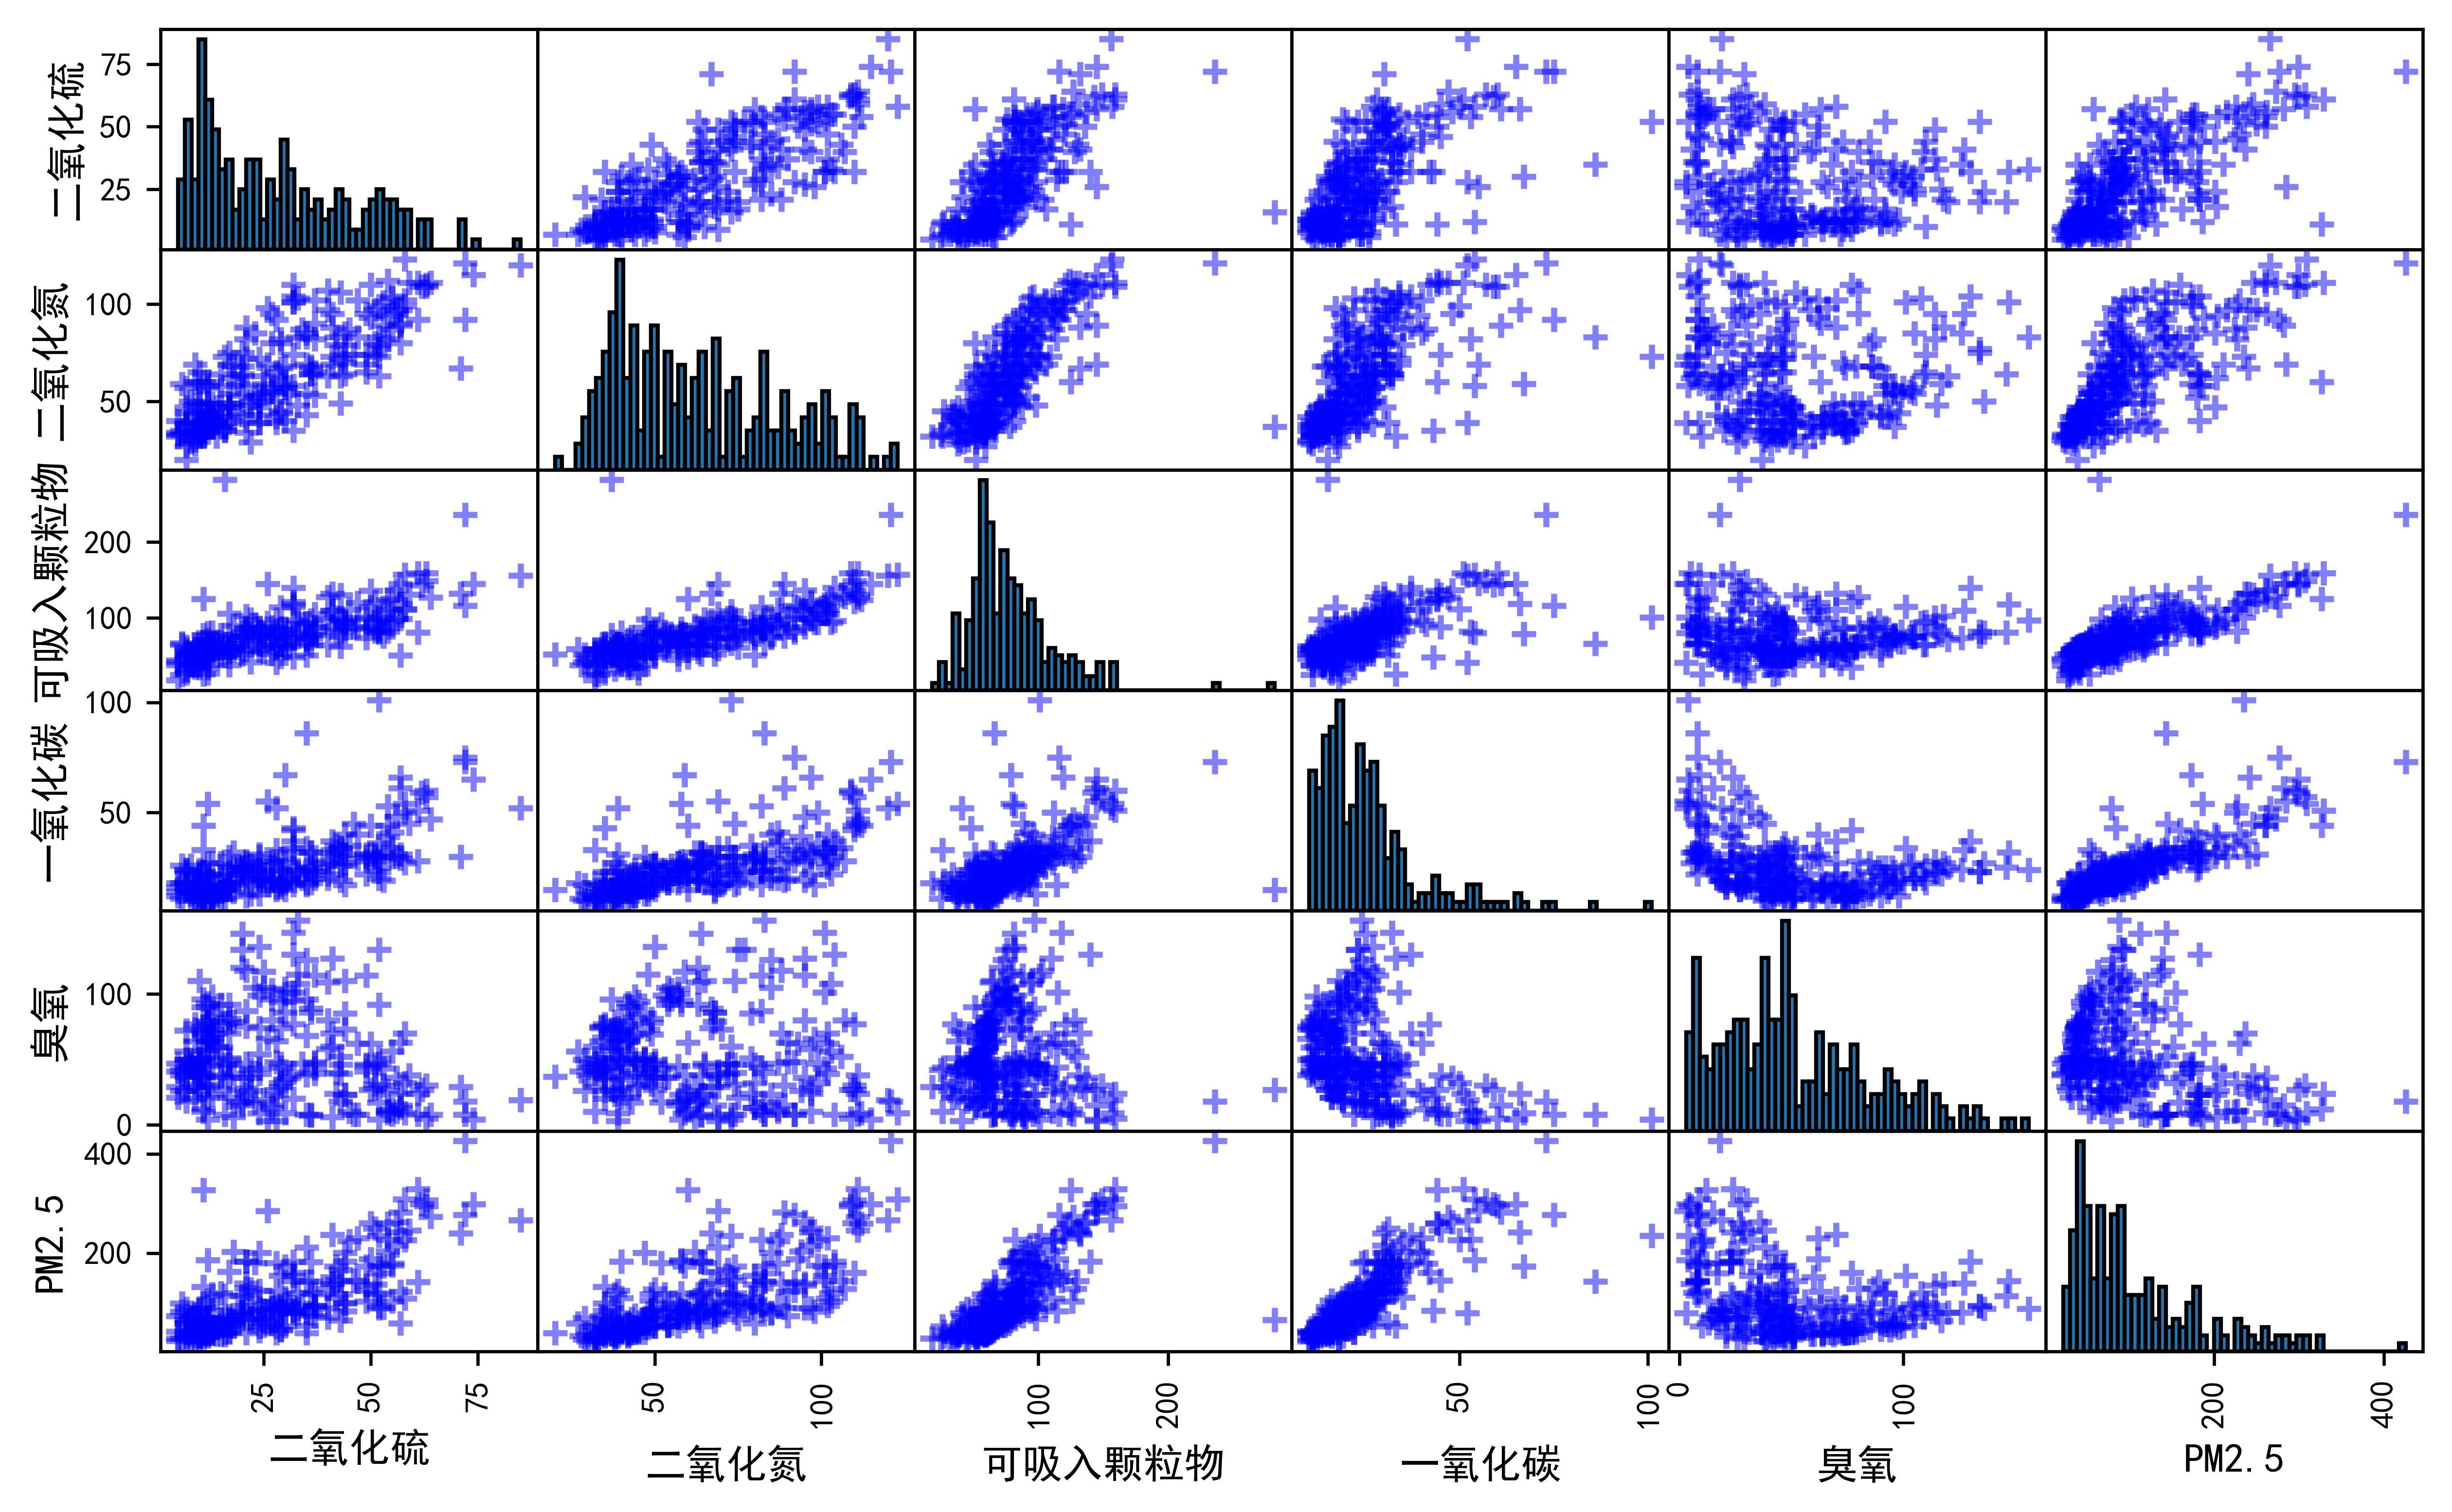
scatter_matrix = pd.plotting.scatter_matrix(data,figsize=(10,6),
c = 'b',
marker = '+',
diagonal='hist',
hist_kwds={'bins':50,'edgecolor':'k'},
alpha = 0.5,
range_padding=0.1)
plt.savefig('scatter_matrix.jpg',dpi = 600,bbox_inches = 'tight')
cor_pm25=data.corr()[u'PM2.5']
print(cor_pm25)
y = data['PM2.5']
x = data['二氧化硫']
poly=np.polyfit(x,y,3)
plt.plot(x, y, 'o')
plt.plot(x, np.polyval(poly, x))
plt.xlabel("二氧化硫")
plt.ylabel("PM2.5")
plt.savefig('SO2.jpg',dpi = 600,bbox_inches = 'tight')
plt.show()
20
import math
evaluate=np.polyval(poly, x) #求拟合值
Rnew=1-math.sqrt(sum((y-evaluate)**2)/sum(y**2))
print(Rnew)
y = data['PM2.5']
x = data['二氧化氮']
poly=np.polyfit(x,y,3)
plt.plot(x, y, 'o')
plt.plot(x, np.polyval(poly, x))
plt.xlabel("二氧化氮")
plt.ylabel("PM2.5")
plt.savefig('NO2.jpg',dpi = 600,bbox_inches = 'tight')
plt.show()
evaluate=np.polyval(poly, x) #求拟合值
Rnew=1-math.sqrt(sum((y-evaluate)**2)/sum(y**2))
print(Rnew)
y = data['PM2.5']
x = data['可吸入颗粒物']
poly=np.polyfit(x,y,3)
plt.plot(x, y, 'o')
plt.plot(x, np.polyval(poly, x))
plt.xlabel("可吸入颗粒物")
plt.ylabel("PM2.5")
plt.savefig('PM10.jpg',dpi = 600,bbox_inches = 'tight')
plt.show()
evaluate=np.polyval(poly, x) #求拟合值
Rnew=1-math.sqrt(sum((y-evaluate)**2)/sum(y**2))
print(Rnew)
y = data['PM2.5']
x = data['一氧化碳']
poly=np.polyfit(x,y,3)
plt.plot(x, y, 'o')
plt.plot(x, np.polyval(poly, x))
plt.xlabel("一氧化碳")
plt.ylabel("PM2.5")
plt.savefig('CO.jpg',dpi = 600,bbox_inches = 'tight')
plt.show()
evaluate=np.polyval(poly, x) #求拟合值
Rnew=1-math.sqrt(sum((y-evaluate)**2)/sum(y**2))
print(Rnew)
y = data['PM2.5']
x = data['臭氧']
poly=np.polyfit(x,y,3)
plt.plot(x, y, 'o')
21
plt.plot(x, np.polyval(poly, x))
plt.xlabel("臭氧")
plt.ylabel("PM2.5")
plt.savefig('O3.jpg',dpi = 600,bbox_inches = 'tight')
plt.show()
evaluate=np.polyval(poly, x) #求拟合值
Rnew=1-math.sqrt(sum((y-evaluate)**2)/sum(y**2))
print(Rnew)
from sklearn import datasets,linear_model
data=data.values
regr = linear_model.LinearRegression()
X = data[:,:4]
y = data[:,5]
regr.fit(X,y)
evaluate=regr.predict(X)
#print(evaluate)
Rnew=1-math.sqrt(sum((y-evaluate)**2)/sum(y**2))
print(Rnew)
第二问:
基于 python
PM2.5 预测(以小寨为例)
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = 'SimHei'
plt.rcParams['axes.unicode_minus'] = False
data = pd.read_excel("附件 2.西安市监测点数据.xls",sheet_name =
None,parse_dates=["时间"])
print(data)
dfs = pd.read_excel("附件 2.西安市监测点数据.xls", sheet_name = None).values()
result = pd.concat(dfs)##将多个表 concatenate
result = result.reset_index(drop=True)##重设序列 0-最后一表的最后一行
result.from_dict(result, orient='columns', dtype=None, columns=None)##将字典类
型转换成 dataframe
result['PM2.5'] = result['PM2.5'].fillna(result['PM2.5'].mean())
result.info()
result['时间'] = pd.to_datetime(result['时间'])
result.sort_values('时间', inplace=True)##各表按时间排序
result
PM = result.pivot(index="时间", columns="点位名称", values="PM2.5")##透视表
print(PM)
PM.columns
PM[PM.columns[1]]
import plotly.express as px
22
import plotly.graph_objects as go
import plotly.io as pio
pio.templates.default = "plotly_white"
plot_template = dict(
layout=go.Layout({
"font_size": 18,
"xaxis_title_font_size": 24,
"yaxis_title_font_size": 24})
)
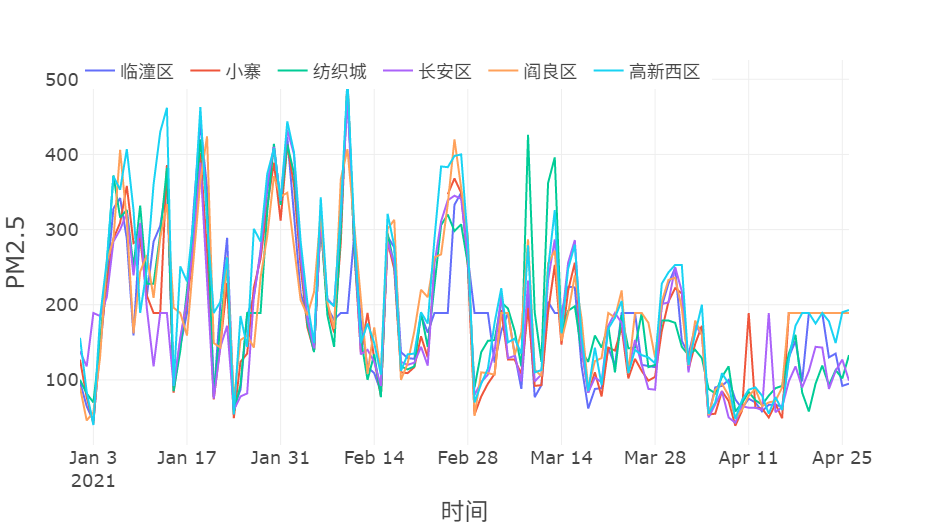
fig = px.line(PM, labels=dict(
date="时间", value="PM2.5",variable="点位名称"
))
fig.update_layout(
template=plot_template, legend=dict(orientation='h', y=1.02, title_text="")
)
fig.show()
data = PM
data.columns
data.info()
data.isnull().any()
data = data.dropna()
data.isnull().any()
data.columns
data.info()
data.columns
target_sensor = PM.columns[1]
features = list(data.columns.difference([target_sensor]))
forecast_lead = 1##前移 1 行,预测未来一天的数值
target = f"{target_sensor}_lead{forecast_lead}"##新列命名为**_1
data[target] = data[target_sensor].shift(-forecast_lead)##删除最后一天值
data = data.iloc[:-forecast_lead]
test_start = "2021-03-17"##设置测试集的开始时间
data_train = data.loc[:test_start].copy()#训练集
data_test = data.loc[test_start:"2021-04-17"].copy()#测试集
#
data_predict = data.loc["2021-04-17":"2021-04-27"].copy()
print("Test set fraction:", len(data_test) / len(data))#计算拆分比例
23
target_mean = data_train[target].mean()#目标站点训练集的平均值
target_stdev = data_train[target].std()#目标站点训练集的标准差
print(data_train.columns)
for c in data_train.columns:
mean = data_train[c].mean()#每个站点训练集的平均值
stdev = data_train[c].std()#每个站点的标准差
data_train[c] = (data_train[c] - mean) / stdev#每个站点减去平均值除以标准偏
差
data_test[c] = (data_test[c] - mean) / stdev

data_predict[c] = (data_predict[c]-mean) / stdev
import torch
from torch.utils.data import Dataset
class SequenceDataset(Dataset):#继承自 Dataset 类的 SequenceDataset 类
def __init__(self, dataframe, target, features, sequence_length=5):
self.features = features
self.target = target
self.sequence_length = sequence_length
self.y = torch.tensor(dataframe[target].values).float()
self.X = torch.tensor(dataframe[features].values).float()
def __len__(self):
return self.X.shape[0]
def __getitem__(self, i):
if i >= self.sequence_length - 1:
i_start = i - self.sequence_length + 1
x = self.X[i_start:(i + 1), :]#返回(i-sequence_length)到 i 行
数据
else:
padding = self.X[0].repeat(self.sequence_length - i - 1, 1)
x = self.X[0:(i + 1), :]
x = torch.cat((padding, x), 0)#填充 padding
return x, self.y[i]
i = 27
sequence_length = 4
24
train_dataset = SequenceDataset(
data_train,
target=target,
features=features,
sequence_length=sequence_length
)
X, y = train_dataset[i]
print(X)
X, y = train_dataset[i + 1]
print(X)
print(data_train[features].iloc[(i - sequence_length + 1): (i + 1)])
from torch.utils.data import DataLoader
torch.manual_seed(99)#设置随机数种子
train_loader = DataLoader(train_dataset, batch_size=3, shuffle=True)
X, y = next(iter(train_loader))
print(X.shape)
print(X)
torch.manual_seed(101)
batch_size = 4
sequence_length = 30
train_dataset = SequenceDataset(
data_train,
target=target,
features=features,
sequence_length=sequence_length
)
test_dataset = SequenceDataset(
data_test,
target=target,
features=features,
sequence_length=sequence_length
)
#
predict_dataset = SequenceDataset(
data_predict,
target=target,
25
features=features,
sequence_length=sequence_length
)
#
train_loader = DataLoader(train_dataset, batch_size=batch_size,
shuffle=True)
test_loader = DataLoader(test_dataset, batch_size=batch_size,
shuffle=False)
X, y = next(iter(train_loader))#next()函数不断调用并返回下一个值 转换为
iterator 可迭代对象
print("Features shape:", X.shape)
print("Target shape:", y.shape)
from torch import nn
class ShallowRegressionLSTM(nn.Module):
def __init__(self, num_sensors, hidden_units):
super().__init__()
self.num_sensors = num_sensors # 特征数量
self.hidden_units = hidden_units
self.num_layers = 1
self.lstm = nn.LSTM(
input_size=num_sensors,
hidden_size=hidden_units,
batch_first=True,#(批,序列,特征)
num_layers=self.num_layers
)
self.linear = nn.Linear(in_features=self.hidden_units,
out_features=1)
def forward(self, x):#初始化 h0 和 c0 为批大小作为第二维度
batch_size = x.shape[0]
h0 = torch.zeros(self.num_layers, batch_size,
self.hidden_units).requires_grad_()
c0 = torch.zeros(self.num_layers, batch_size,
self.hidden_units).requires_grad_()
_, (hn, _) = self.lstm(x, (h0, c0))
out = self.linear(hn[0]).flatten() #线性输出层,回归任务单输出单元
# hn 的第一维是层数(在上面设为一)
26
return out
learning_rate = 0.001#5e5
num_hidden_units = 16#16
model = ShallowRegressionLSTM(num_sensors=len(features),
hidden_units=num_hidden_units)
loss_function = nn.MSELoss()#损失函数采用均方误差损失
optimizer = torch.optim.Adam(model.parameters(), lr=learning_rate)
def train_model(data_loader, model, loss_function, optimizer):
num_batches = len(data_loader)
total_loss = 0
model.train()
for X, y in data_loader:
output = model(X)
loss = loss_function(output, y)
optimizer.zero_grad()
loss.backward()
optimizer.step()
total_loss += loss.item()
avg_loss = total_loss / num_batches
print(f"Train loss: {avg_loss}")
def test_model(data_loader, model, loss_function):
num_batches = len(data_loader)
total_loss = 0
model.eval()
with torch.no_grad():
for X, y in data_loader:
output = model(X)
total_loss += loss_function(output, y).item()
avg_loss = total_loss / num_batches
print(f"Test loss: {avg_loss}")
print("Untrained test\n--------")
test_model(test_loader, model, loss_function)
27
print()
for ix_epoch in range(50):##epoch changed
print(f"Epoch {ix_epoch+1}\n---------")
train_model(train_loader, model, loss_function, optimizer=optimizer)
test_model(test_loader, model, loss_function)
print()
def predict(data_loader, model):
output = torch.tensor([])
model.eval()
with torch.no_grad():
for X, _ in data_loader:
y_star = model(X)
output = torch.cat((output, y_star), 0)
return output
train_eval_loader = DataLoader(train_dataset, batch_size=batch_size,
shuffle=False)
ystar_col = "Model forecast"#预测列
data_train[ystar_col] = predict(train_eval_loader, model).numpy()
data_test[ystar_col] = predict(test_loader, model).numpy()
data_out = pd.concat((data_train, data_test))[[target, ystar_col]]
for c in data_out.columns:
data_out[c] = data_out[c] * target_stdev + target_mean#还原出预测值
print(data_out)
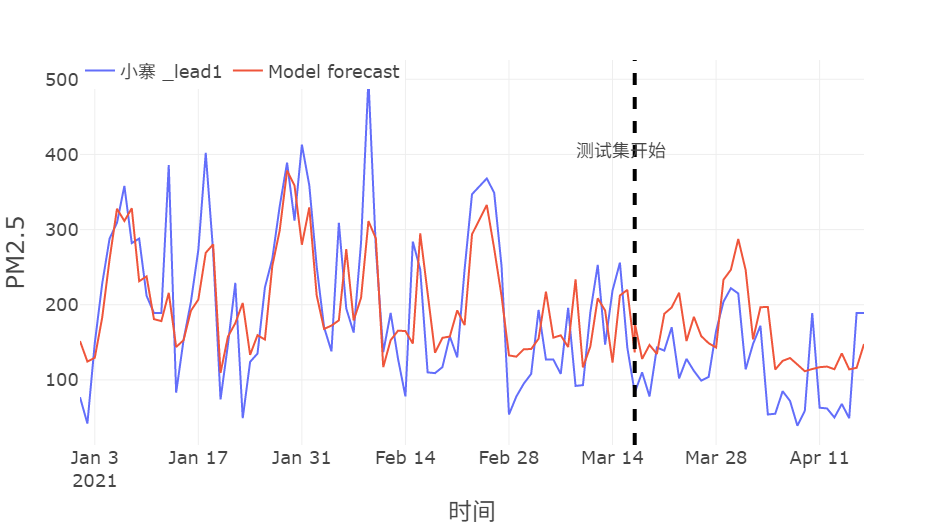
fig = px.line(data_out, labels=dict(date="时间", value="PM2.5"))
fig.add_vline(x=test_start, line_width=4, line_dash="dash")
fig.add_annotation(xref="paper", x=0.75, yref="paper", y=0.8, text="测试集
开始", showarrow=False)
fig.update_layout(
template=plot_template, legend=dict(orientation='h', y=1.02,
title_text="")
)
fig.show()
def predict(data_loader, model):
output = torch.tensor([])
28
model.eval()
with torch.no_grad():
for X, _ in data_loader:
y_star = model(X)
output = torch.cat((output, y_star), 0)
return output
predict_loader = DataLoader(predict_dataset, batch_size=batch_size,
shuffle=False)
train_eval_loader = DataLoader(train_dataset, batch_size=batch_size,
shuffle=False)
ystar_col = "forecast"#预测列
data_train[ystar_col] = predict(train_eval_loader, model).numpy()
data_test[ystar_col] = predict(test_loader, model).numpy()
data_predict[ystar_col] = predict(predict_loader, model).numpy()
data_out = pd.concat((data_test, data_predict))[[target, ystar_col]]
for c in data_out.columns:
data_out[c] = data_out[c] * target_stdev + target_mean#还原出预测值
print(data_out)
AQI 计算
import pandas as pd
import numpy as np
iaqi = 0
def cal_linear(iaqi_lo, iaqi_hi, bp_lo, bp_hi, cp):
iaqi = (iaqi_hi - iaqi_lo) * (cp - bp_lo) / (bp_hi - bp_lo) +iaqi_lo
return iaqi
def cal_pm_iaqi(pm_val):
global iaqi
# 计算 PM2.5 的 IAQI
if 0.0 <= pm_val < 36.0: iaqi=cal_linear(0.0, 50.0, 0.0, 35.0, pm_val) elif 36.0 <=pm_val < 76.0: iaqi=cal_linear(50.0,
    100.0, 35.0, 75.0, pm_val) elif 76.0 <=pm_val < 116.0: 29 iaqi=cal_linear(100.0, 150.0, 75.0, 115.0, pm_val) elif
    116.0 <=pm_val < 151.0: iaqi=cal_linear(150.0, 200.0, 115.0, 150.0, pm_val) elif 151.0 <=pm_val < 251.0:
    iaqi=cal_linear(200.0, 300.0, 150.0, 250.0, pm_val) elif 251.0 <=pm_val < 351.0: iaqi=cal_linear(300.0, 400.0,
    250.0, 350.0, pm_val) elif 351.0 <=pm_val < 501.0: iaqi=cal_linear(400.0, 500.0, 350.0, 500.0, pm_val) else: pass
    return iaqi def cal_co_iaqi(co_val): global iaqi # 计算 co 的 IAQI if 0.0 <=co_val < 3.0: iaqi=cal_linear(0.0, 50.0,
    0.0, 2.0, co_val) elif 3.0 <=co_val < 5.0: iaqi=cal_linear(50.0, 100.0, 2.0, 4.0, co_val) elif 5.0 <=co_val < 15.0:
    iaqi=cal_linear(100.0, 150.0, 4.0, 14.0, co_val) elif 15.0 <=co_val < 25.0: iaqi=cal_linear(150.0, 200.0, 14.0,
    24.0, co_val) elif 25.0 <=co_val < 37.0: iaqi=cal_linear(200.0, 300.0, 24.0, 36.0, co_val) elif 37.0 <=co_val <
    49.0: iaqi=cal_linear(300.0, 400.0, 36.0, 48.0, co_val) elif 49.0 <=co_val < 61.0: iaqi=cal_linear(400.0, 500.0,
    48.0, 60.0, co_val) else: pass return iaqi data=pd.read_excel("附件 2.西安市监测点数据.xls") data
    data['PM2.5']=data['PM2.5'].fillna(data['PM2.5'].mean()) data['CO']=data['CO'].fillna(data['CO'].mean())
    data.columns data[['CO','PM2.5']] data['AQI_CO']=data.apply(lambda col: cal_co_iaqi(col['CO']), axis=1)
    data['AQI_PM']=data.apply(lambda col: cal_pm_iaqi(col['PM2.5']), axis=1) data.to_excel('AQI_.xls') 第四问 基于 python
    import pandas as pd 30 data=pd.read_excel("附件 3.西安地区气象数据.xls") data data.columns data['Unnamed: 1']
    se=pd.Series(data['Unnamed: 1']) countDict=dict(se.value_counts())
    proportitionDict=dict(se.value_counts(normalize=True)) print(countDict) freq=countDict freq df=pd.DataFrame([freq])
    df df.to_excel('天气.xls') import pandas as pd data=pd.read_excel("附件 3.西安地区气象数据.xls") data data.columns
    data['Unnamed: 3'] se=pd.Series(data['Unnamed: 3']) countDict=dict(se.value_counts())
    proportitionDict=dict(se.value_counts(normalize=True)) print(countDict) freq=countDict freq df=pd.DataFrame([freq])
    df df.to_excel('风向.xls')